「データベースの正規化」という言葉、資格の教科書で見かけるけれど、実務でどう使うのかピンとこない——編集部にもそんな相談がよく届きます。改めて整理してみると、実は引っ越しの荷物整理の発想ととても近いことに気づきました。
まず結論:正規化と非正規化は「重複を減らすか、速さを優先するか」が違う
- 正規化:データの重複をなくし、更新ミスや矛盾(不整合)を防ぐための設計手法
- 非正規化:あえて重複を許容し、検索・集計の速度を優先する設計手法
- 実務の基本方針は「まず正規化して整理し、パフォーマンスが必要な箇所だけ非正規化する」
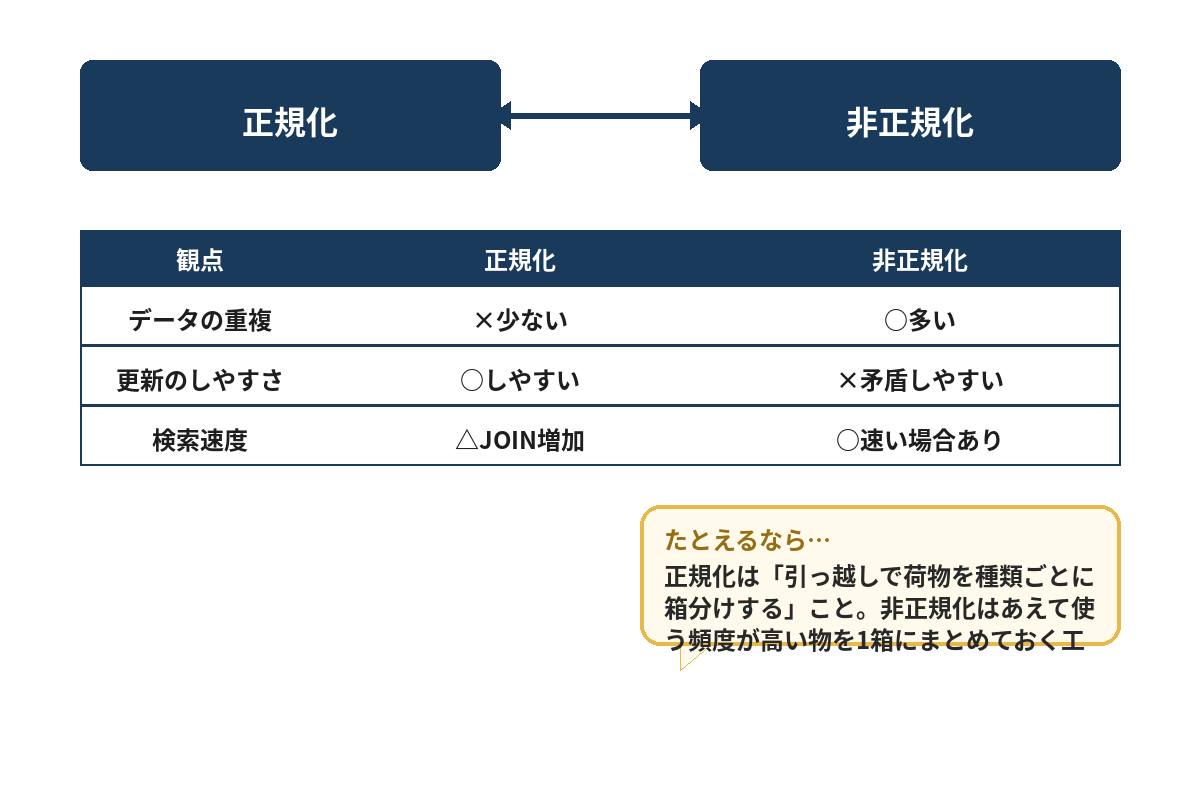
正規化とは?――「同じ物は一箇所にしかしまわない」片付けのようなもの
引っ越しの荷物整理を想像してほしい。同じ本を寝室にもリビングにも重複して置いていたら、模様替えのたびにどちらも動かさなければならず、片方だけ動かし忘れると「あの本、どこだっけ」と混乱する。
データベースの正規化も考え方は同じ。例えば「注文テーブル」に顧客の名前・住所・電話番号をそのまま書き込んでしまうと、同じ顧客が何度も注文するたびに同じ情報が重複して保存される。もし顧客が引っ越して住所が変わったとき、過去の注文データすべてを更新しなければ情報が食い違ってしまう。
正規化では、顧客情報は「顧客テーブル」に一箇所だけ置き、注文テーブルからは顧客IDで参照する形に分割する。これにより「同じ情報は一箇所にしかしまわない」状態になり、更新漏れによる矛盾(更新不整合)を防げる。
非正規化とは?――「よく使う物は手元にまとめて置いておく」引き出しのようなもの
一方で、片付けを徹底しすぎると不便なこともある。毎朝使う歯ブラシや化粧品を、わざわざ別の部屋の収納にしまっていたら、使うたびに取りに行く手間がかかる。多少場所は重複しても、よく使う物は手元の引き出しにまとめておいたほうが効率的な場合がある。
非正規化はこれと同じ発想で、正規化によって分割したテーブルを、パフォーマンス向上のためにあえて結合したり、集計済みの値を重複して持たせたりする設計手法。例えば「注文一覧画面」で毎回、顧客テーブルと注文テーブルを結合(JOIN)して顧客名を取得していると、アクセスが集中したときに処理が遅くなることがある。そこで注文テーブルに顧客名も一緒に保存しておけば、結合処理を省略でき、表示が速くなる。
ただし代償もある。顧客名を変更したとき、注文テーブル側の重複データも合わせて更新しないと情報が食い違う。非正規化は「速さと引き換えに、整合性を保つ手間を増やす」トレードオフの選択だと理解しておきたい。
「正規化」と「非正規化」の違いをたとえでわかりやすく解説
| 観点 | 正規化 | 非正規化 |
|---|---|---|
| 主な目的 | データの重複を排除し、整合性を保つ | 検索・集計を高速化する |
| データの持ち方 | 情報を分割し、関連テーブルを参照する | あえて重複や結合結果を保存する |
| 更新のしやすさ | 一箇所を直せば済むので更新ミスが起きにくい | 重複箇所すべてを直す必要があり、更新ミスのリスクがある |
| 検索・集計の速度 | JOIN(結合)が発生しやすく、遅くなる場合がある | JOINを減らせるため速くなりやすい |
| 向いている場面 | 更新が多く、データの正確性が重要なシステム | 読み取り(参照)が多く、速度が求められるシステム |
なぜ正規化だけではダメなのか?
正規化を徹底すればするほど、テーブルは細かく分割されていく。理屈の上ではデータの整合性は高まるが、実際の業務システムでは、画面を1つ表示するために5つも6つものテーブルを結合しなければならない、という状況が起こりうる。
テーブルの結合(JOIN)は、テーブルの件数が増えるほど処理コストが大きくなりやすい。アクセスが集中するECサイトの商品一覧や、大量データを扱う集計レポートなどでは、正規化を優先しすぎると表示速度が実用に耐えないほど遅くなることがある。
だからこそ実務では「正規化して整合性を確保しつつ、パフォーマンスがどうしても必要な箇所だけ、目的を限定して非正規化する」という折衷案が取られることが多い。どこを非正規化するかの判断には、どのくらいの頻度で読み書きされるデータか、更新時の不整合リスクをどこまで許容できるかという見極めが欠かせないと編集部は考えている。
正規化の進め方・ステップ解説
正規化には段階があり、資格試験では特に「第一正規形」「第二正規形」「第三正規形」までが頻出する。
| 段階 | 内容 |
|---|---|
| 第一正規形 | 1つのセルに複数の値を入れない(繰り返し項目を排除する) |
| 第二正規形 | 主キーの一部だけに依存する項目を、別テーブルに分離する |
| 第三正規形 | 主キー以外の項目に依存する項目(推移的関数従属)を、別テーブルに分離する |
段階を踏むごとにテーブルは分割され、データの重複は減っていく。基本情報技術者試験などでは、この3段階の考え方と、それぞれの段階で何が排除されるかを問う問題が繰り返し出題される傾向がある。
まとめ:3行で理解する正規化と非正規化
正規化は「重複をなくして整合性を守る」設計、非正規化は「重複を許して速度を稼ぐ」設計。実務では、まず正規化を基本としながら、パフォーマンスが必要な部分だけ目的を絞って非正規化するのが現実的な進め方だと編集部では考えている。完璧な正規化にこだわりすぎず、システムの使われ方に応じて柔軟に判断することが、結局は使いやすい設計につながる。
よくある質問
Q1. 正規化はどこまでやればいいのでしょうか?
一律の正解はないが、実務では第三正規形までを目安にする設計が多い。それ以上の正規化(第四正規形やボイス・コッド正規形など)は理論的には存在するが、実務での適用頻度は高くなく、資格試験でも出題頻度は第三正規形までに比べて限定的。まずは第三正規形の考え方を確実に理解しておくことをおすすめする。
Q2. 非正規化をするとどんなリスクがありますか?
最大のリスクは「更新不整合」。重複して持たせたデータの一部だけを更新し忘れると、同じはずの情報が食い違ってしまう。非正規化を行う場合は、更新処理を自動化する仕組み(トリガーやバッチ処理など)を合わせて設計し、人手による更新漏れを防ぐ工夫が必要になる。
Q3. 基本情報技術者試験では正規化・非正規化はどこまで問われますか?
正規化については、第一〜第三正規形の考え方や、関数従属性(ある項目が別の項目によって一意に決まる関係)を理解しているかを問う問題が出題される。非正規化そのものよりも、「なぜ正規化が必要か」「正規化のプロセスでテーブルがどう分割されるか」を問う出題が中心になる傾向がある。
Q4. NoSQLデータベースでも正規化の考え方は必要ですか?
MongoDBのようなドキュメント指向のNoSQLでは、あえてデータを1つのドキュメントにまとめて持たせる(非正規化に近い)設計が好まれることが多い。ただしこれは「正規化の考え方が不要」という意味ではなく、「データの重複と検索速度のどちらを優先するか」というトレードオフの判断軸は、リレーショナルデータベースと共通している。
コメント