データベース設計を学び始めると必ず出てくる「インデックス」と「キー」。どちらも似たような場面で登場するため、「結局何が違うの?」と混同している人が多いのではないだろうか。編集部で改めて整理してみると、図書館の仕組みに置き換えるとすっきり理解できることに気づいた。
まず結論:インデックスとキーは「目的」が違う
- キー:データの一意性や関連性を保証するための「識別・制約」の仕組み(主キー・外部キーなど)
- インデックス:検索を高速化するための「目印・索引」の仕組み
- 主キーには自動的にインデックスが張られることが多いが、両者はイコールではない
キーとは?――図書館の「管理番号」のようなもの
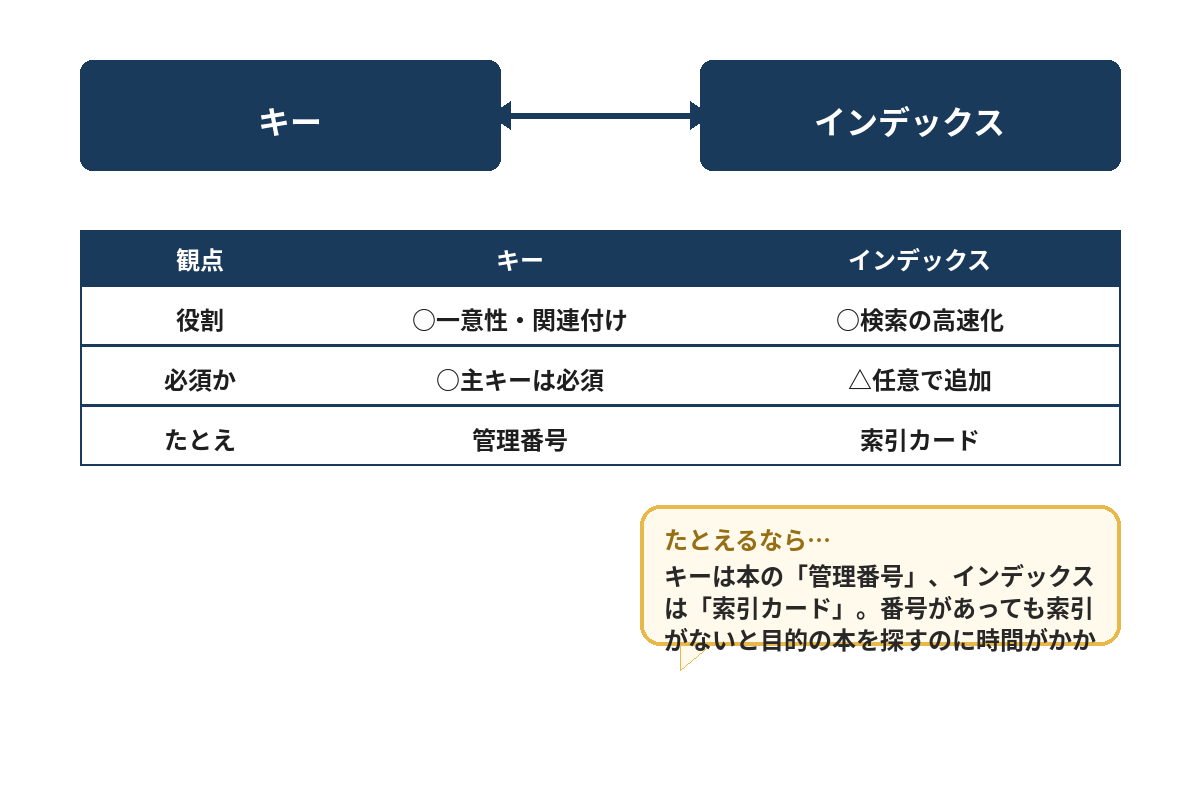
図書館の本には、1冊ずつ重複しない管理番号が割り振られている。この番号があるおかげで、同じタイトルの本が複数冊あっても、どの本がどれなのかを正確に識別できる。
データベースの「主キー(プライマリキー)」もこれと同じ役割を持つ。テーブルの各行(レコード)に対して、絶対に重複しない値を割り当てることで、「このデータはこれ」と一意に特定できるようにする。例えば会員テーブルであれば「会員ID」が主キーになることが多い。
さらに「外部キー」という仕組みもある。これは、あるテーブルの列が、別のテーブルの主キーを参照する関係を表すもの。図書館でいえば、貸出記録カードに「本の管理番号」を書いておくことで、どの記録がどの本に対応するかを追跡できるイメージに近い。キーは検索を速くするための仕組みというより、データの整合性や関連性を「保証」するための制約だと理解しておきたい。
インデックスとは?――本を探すための「索引カード」のようなもの
一方インデックスは、図書館で本を探すときに使う索引カード(あるいは背表紙のジャンル別ラベル)に近い。膨大な蔵書の中から目当ての本を探すとき、番号順に棚の端から端まで見て回っていては日が暮れてしまう。あらかじめ「あ行」「か行」といった索引や、ジャンル別の分類があるおかげで、目的の本にすばやくたどり着ける。
データベースのインデックスも同じ発想で、特定の列の値をあらかじめ整列・整理した索引データを作っておくことで、検索処理を高速化する仕組み。例えば「メールアドレスで会員を検索する」処理が頻繁に発生するなら、メールアドレス列にインデックスを張ることで、テーブル全体を1行ずつ確認する(フルスキャンする)必要がなくなり、検索が大幅に速くなる。
ただしインデックスは万能ではない。索引を作れば作るほど、データを書き込む(挿入・更新・削除する)たびに索引側も更新しなければならず、書き込み処理は遅くなる。「検索は速くなるが、更新は遅くなる」というトレードオフがある点は、資格試験でもよく問われるポイントだと編集部は感じている。
「キー」と「インデックス」の違いをたとえでわかりやすく解説
| 観点 | キー | インデックス |
|---|---|---|
| 主な目的 | データの一意性・整合性を保証する(制約) | 検索処理を高速化する(性能向上) |
| 図書館でのたとえ | 本ごとの一意な管理番号 | 本を探すための索引・分類ラベル |
| 種類の例 | 主キー、外部キー、一意キー(ユニークキー) | 単一列インデックス、複合インデックスなど |
| 重複の可否 | 主キーは重複不可(一意性が必須) | 対象列の値自体は重複してもよい |
| 書き込み時の影響 | 制約違反がなければ特に速度への影響は小さい | データ更新のたびに索引の再構築が発生し、書き込みがやや遅くなる |
なぜキーだけ・インデックスだけではダメなのか?
キーだけで運用しようとすると、テーブルの行数が増えたときに検索速度が大きな問題になる。主キーで検索する分にはインデックスが自動生成されているため速いが、主キー以外の列(例えば「氏名」や「登録日」)で検索・絞り込みをする処理が多いシステムでは、キーだけでは検索の遅さをカバーできない。
逆にインデックスだけに頼り、キー(特に主キーや外部キーによる制約)を設定しないと、同じデータが重複して登録されたり、存在しないはずの関連データが紐づいてしまったりと、データの整合性が崩れるリスクが高まる。検索が速くても、データそのものが信頼できなければ本末転倒になってしまう。
だからこそ実務では「整合性を守るためのキー設計」と「性能を確保するためのインデックス設計」を、それぞれ目的の異なる別々の設計作業として検討することが望ましいと編集部は考えている。
インデックス設計の考え方・ステップ解説
| ステップ | 内容 |
|---|---|
| 1. 検索頻度の高い列を洗い出す | WHERE句やJOIN条件で頻繁に使われる列を確認する |
| 2. 更新頻度とのバランスを検討する | 書き込みが多い列に安易にインデックスを増やしすぎない |
| 3. 複合インデックスを検討する | 複数列を組み合わせた検索が多い場合は複合インデックスも選択肢に入れる |
| 4. 定期的に見直す | 使われていないインデックスは削除し、無駄な更新コストを減らす |
まとめ:3行で理解するインデックスとキー
キーは「データの一意性・整合性を守る制約」、インデックスは「検索を速くする索引」。役割がまったく異なるからこそ、片方だけで設計を済ませようとせず、両方を目的に応じて使い分けることが大切だと編集部では考えている。主キーにインデックスが自動で付くからといって、インデックス設計そのものを軽視しないようにしたい。
よくある質問
Q1. 主キーを設定すれば、インデックスは別に作らなくていいですか?
主キーの列には自動的にインデックスが作成されることが多いが、それはあくまで主キー列を検索条件にしたときの話。氏名やメールアドレスなど、主キー以外の列で頻繁に検索する場合は、その列に対して別途インデックスを検討する必要がある。
Q2. インデックスを増やせば増やすほど検索は速くなりますか?
検索については速くなる場合が多いが、データの挿入・更新・削除のたびにインデックスの再構築処理が発生するため、書き込み処理は遅くなりやすい。特に更新頻度の高いテーブルにインデックスを乱立させると、全体としてのパフォーマンスが悪化することもあるため、検索頻度と更新頻度のバランスを見て設計する必要がある。
Q3. 外部キーとインデックスは何が違うのですか?
外部キーは「あるテーブルの列が、別テーブルの主キーと対応している」ことを保証する制約であり、目的はデータの整合性の維持にある。一方インデックスは検索速度の向上が目的。多くのデータベース製品では外部キー列にインデックスが自動で作られない場合もあるため、結合(JOIN)処理が多い場合は明示的にインデックスを検討する必要がある。
Q4. 基本情報技術者試験では、キーとインデックスはどう問われますか?
主キー・外部キー・一意制約といった「キー」の概念は、関係データベースの正規化や整合性制約と絡めて出題される頻度が高い。インデックスについては、検索の高速化という目的や、B木(B-Tree)などの索引構造の基本的な考え方が問われることがある。
コメント